这个概念我倒是很早就知道了。但是公司里类似知识库的项目都停摆了,所以 LLM Wiki 一直躺在我的收藏夹里吃灰,原本是想拿来搭建个人知识库的。不过凑巧昨晚刷抖音,看到一位宝妈博主正在分享,突然想起来,我也在做自媒体来着。
最近又有人跟我争论,说他们公司从来不用 RAG,用的是 LLM Wiki。我懒得争论,我猜他们想说的,是不用“切片、向量化、召回”那套流程。至于 RAG 的范围,上一篇已经讲过了,这里就不继续掰扯了。
那么,下面是我这个碳基生物结合资料整理出的理解:LLM Wiki,就是让模型把零散资料整理成相互链接的知识页面,并持续维护它们。
Wiki 里多了一个负责整理的模型
Wiki 可以理解为一种方便协作编辑、用链接串起知识页面的形式,维基百科就是熟悉的例子。个人也可以维护自己的 Wiki。MediaWiki 的介绍解释了这类系统的基本特点。
这里说的 LLM Wiki,按 Karpathy 的原始说明来理解:它是一种组织知识的思路,具体软件和工作流可以不同。
原文里把东西分成了三层:
- 原始资料:文章、论文、记录之类,只读,模型不改它。
- Wiki 本身:模型写的一堆 Markdown 页面,概念解释、主题归纳、资料之间的关联都在这里,基本由模型维护。
- 维护规则:一份类似
CLAUDE.md、AGENTS.md的说明文件,约定页面怎么组织、出处怎么写、新资料进来该干什么。
看到这里我有点乐,我这个博客仓库里就躺着一份
AGENTS.md,只不过管的是 Hugo 和导航图标,不是知识页面[Doge]
日常动作也就三个。新资料进来叫 ingest:模型读一遍,写摘要,顺手更新相关的概念页和交叉链接,原文说一份资料可能会牵动十几个页面。提问叫 query:模型先查这些页面再回答,必要时回看原文;聊出来值得留的分析,核对后也可以写回去,不让它烂在聊天记录里。还有一个容易被忽略的 lint:隔一段时间让模型巡检一遍,找互相矛盾的说法、过时的结论、没人链接的孤儿页面。
为了不迷路,原文还建议放两个文件:index.md 按分类列出所有页面,每次入库都更新;log.md 只追加不修改,按时间记下每次做了什么。大概长这样(示意):
| |
| |
工具方面,原文用的是 Obsidian 当编辑器,配合 Web Clipper 抓网页。说白了,载体就是一个普通的 Markdown 文件夹,换什么编辑器都行。
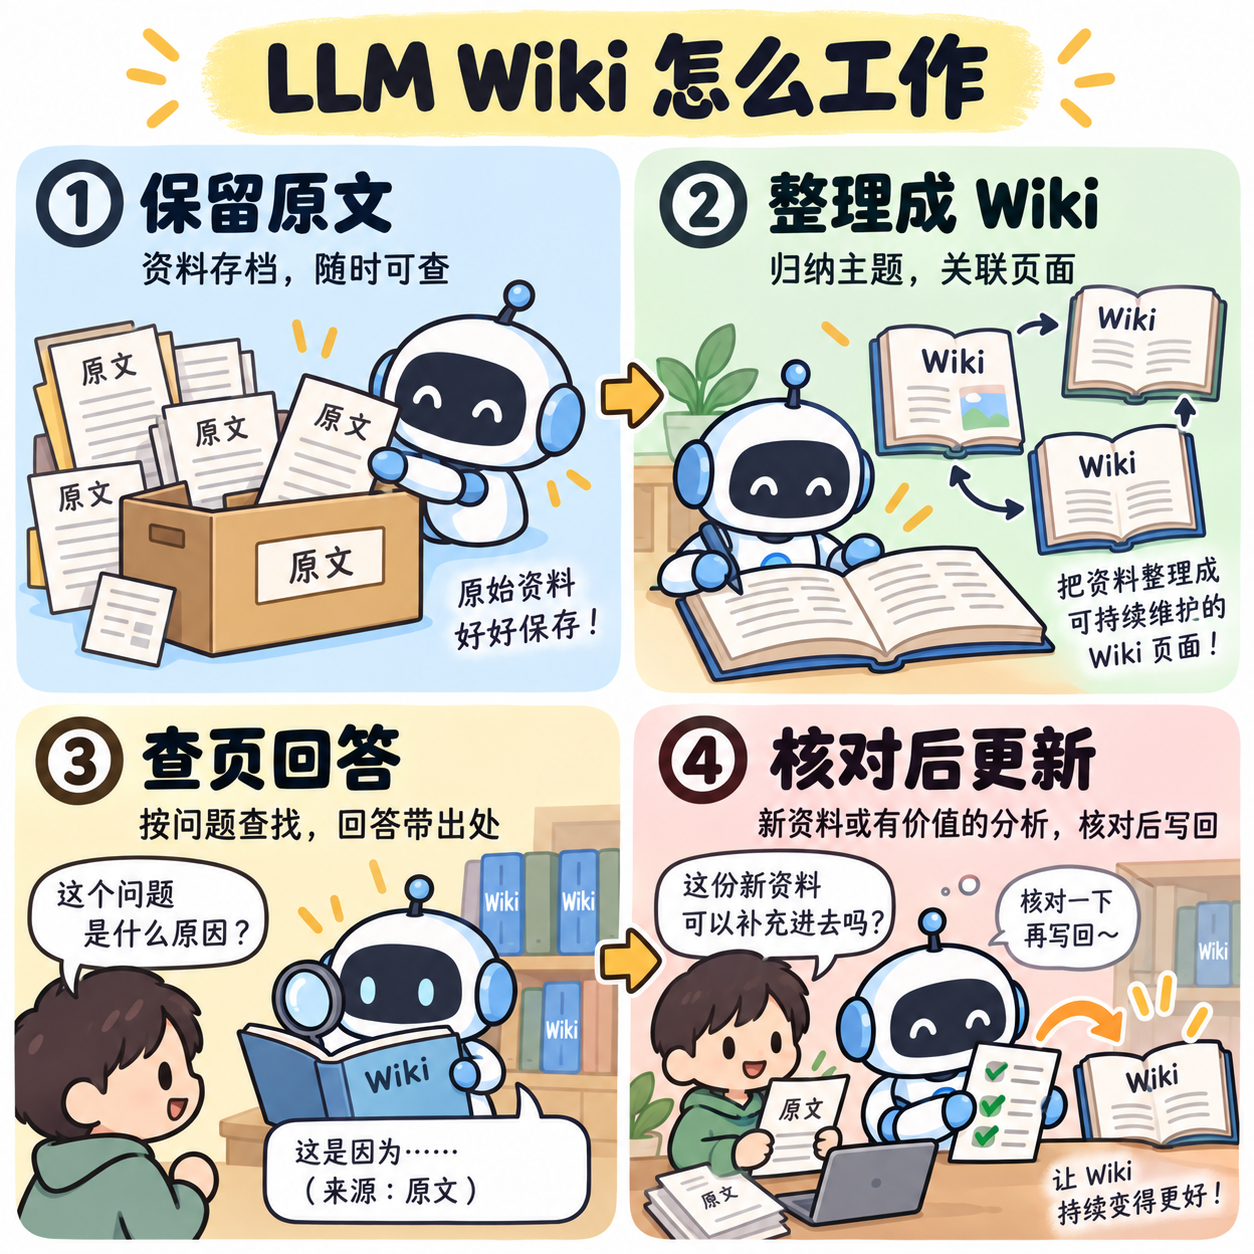
资料入库时整理,提问时读取;维护规则约定页面结构、出处和更新方式。
这层文件保存了整理成果,模型下次仍要读取它们。不能理解成“模型已经把知识永久学进脑子里了”。
举个例子
假设手里有三份资料:v1 部署文档建议打开缓存;后来一份故障记录说,缓存会返回过期数据;再后来,v2 发布说明宣布修复了这个问题。
如果只给每份文档各写一段摘要,还需要再把这三件事串起来。Wiki 可以围绕“缓存策略”维护一页,写清楚适用版本、故障现象和修复情况,并链接回三份原文。
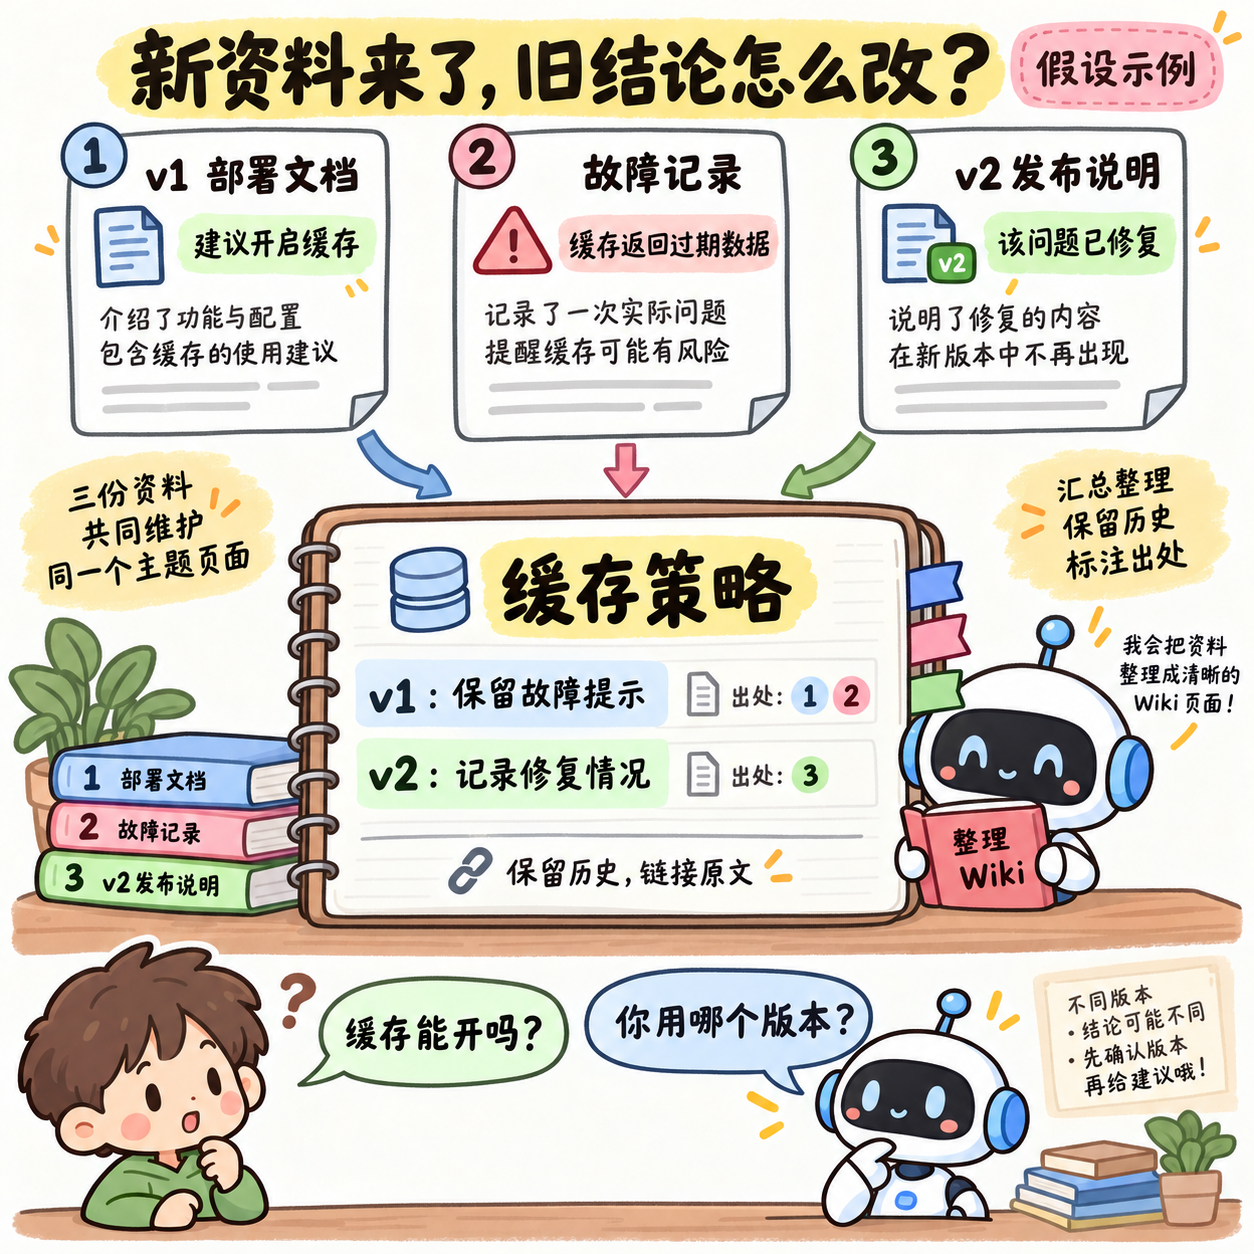
假设示例:三份资料共同维护一个主题页面,版本条件与出处一起保留。
这样再问“缓存能不能开”,模型可以先读这一页,同时确认用户用的版本。新版本修好了,也不能顺手把仍在用旧版本的人一起算进去。
和 RAG 比有什么区别
简单的向量检索流程,通常是先切片建索引,等提问时召回片段,再让模型综合。LLM Wiki 则把一部分跨资料整理提前做,并把结果保存下来复用。这里比较的是这种简单流程,RAG 也可以使用预先整理好的资料。
至于找页面,用目录、关键词还是向量,仍然是实现选择。原始说明就提到可以接入 qmd,而 qmd 支持 BM25、向量检索和重排。光看“LLM Wiki”这个名字,判断不了底下有没有向量。
对我来说,更值得留意的是维护成本。整理提前做,调用成本也提前发生;资料变了,哪些页面需要跟着改?摘要写错了,会不会被后面的回答反复引用?
这有点像传话游戏,第一个人听错一个字,传到最后一个人那里已经面目全非。RAG 每次都回去翻原文,错了也只错这一次;Wiki 是在自己写过的东西上继续写,错误会跟着复利。原文里那句“the wiki is a persistent, compounding artifact”,知识能复利,错误也能。
所以 lint 不是可有可无的步骤,原文、出处和 log.md 这种修改记录也必须留着,出了问题才能顺着链接查回去。让模型维护,不等于免检。
不过我还没真正跑起来过,所以只能浅浅讲一讲。收藏夹里吃灰的那个个人知识库,回头找个周末拿它试试,跑出点东西再来补一篇。